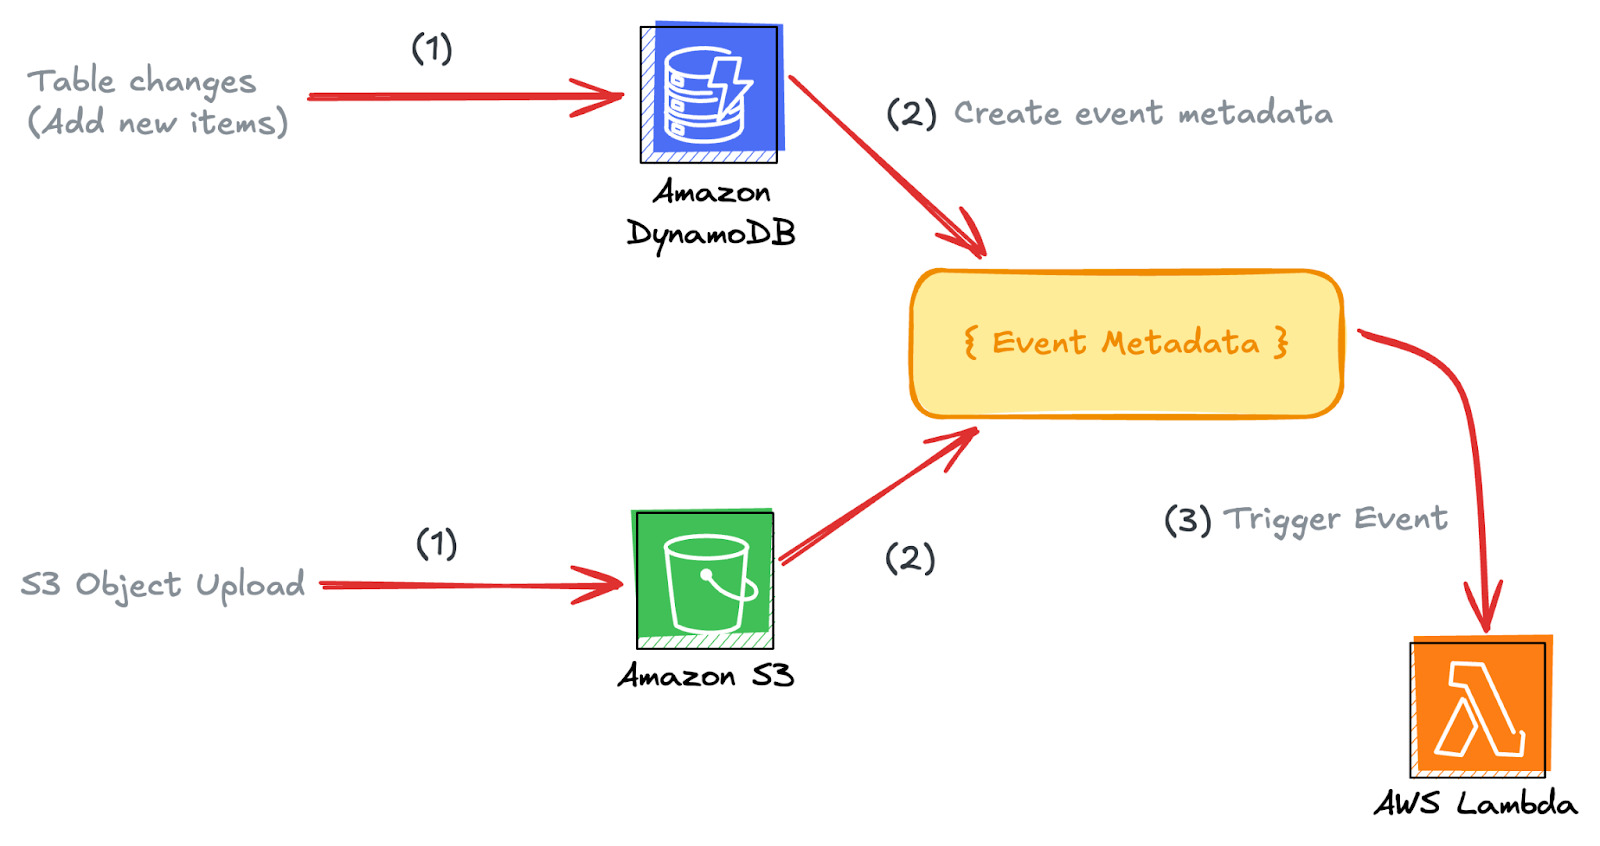
「Mastering AWS Lambda(英語) with Bao」シリーズへようこそ!前回のエピソードでは、AWS Lambdaのトリガーとイベントを通じて、Lambdaが外部とどのようにつながるのかを解説しました。S3とDynamoDB Streamsのトリガーを使い、複数のソースからのイベントを処理してワークフローを自動化する例を紹介し、Lambdaのイベント駆動アーキテクチャを理解するための土台をつくりました。
しかし、信頼性の高いLambda関数を構築するには、トリガーの仕組みを理解するだけでは不十分です。実際の本番ワークロードに耐えるAWS Lambda関数を作成する(英語)には、パフォーマンスの最適化、堅牢なエラーハンドリング、強固なセキュリティ対策に取り組む必要があります。これらに取り組むことで、Lambda関数のスケーラビリティ、効率、セキュリティが高まります。
今回は、信頼性の高いAWS Lambda関数を構築するためのベストプラクティスとして、次の2つの重要なテーマを取り上げます。
- パフォーマンスの最適化:レイテンシの削減、リソースの管理、実行効率の向上
- エラーハンドリングとログ出力:意味のあるエラーの捕捉、CloudWatchでの効果的なログ出力、リトライの設定
これらのベストプラクティスを取り入れることで、本番環境でも安定して動作するLambda関数を構築できます。
パフォーマンスの最適化
Lambda関数を最小限のレイテンシとコストで効率よく動かすためのポイントを解説します。まずは、多くの開発者が気にするコールドスタートから見ていきます。
コールドスタートとは
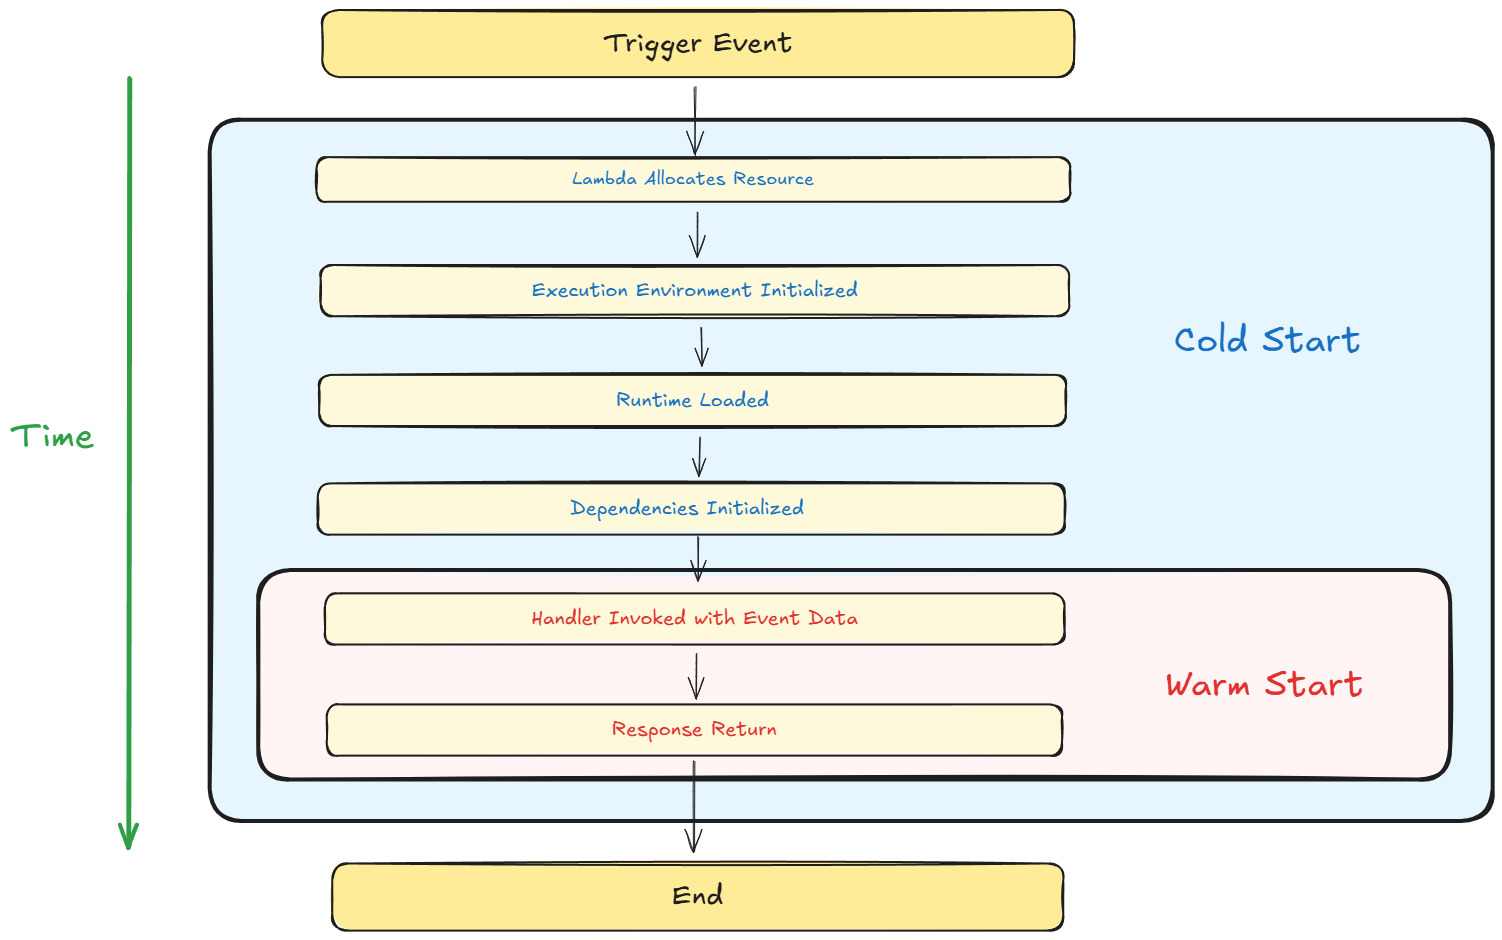
コールドスタートとは、受信したリクエストを処理するために、AWS Lambdaが新しい実行環境を初期化することです。次のような場合に発生します。
- Lambda関数が初めて呼び出されたとき
- 一定時間呼び出しがなかった後(実行環境は数分間アクティビティがないと回収され、自動的にシャットダウンされます)
- 同時リクエストの増加に対応するためにスケールアップするとき
コールドスタートでは、AWSが新しい実行環境をゼロから準備する必要があるため、レイテンシが発生します。
コールドスタートの流れ
- リソースの割り当て:
- AWSがLambda関数用に、安全で分離されたコンテナを用意します。
- 関数の設定に応じて、メモリやCPUなどのリソースが割り当てられます。
- 実行環境の初期化:
- AWSがサンドボックス環境を準備します。
- 一時ストレージ用の /tmpディレクトリ
- VPC内で動くLambdaの場合は、Elastic Network Interface(ENI)などのネットワーク設定
- ランタイムの初期化:
- 指定したランタイム(Node.js、Python、Javaなど)が初期化されます。
- Node.jsの場合は、JavaScriptエンジン(V8)とランタイムAPIが読み込まれます。
- 依存関係の初期化:
- AWSがデプロイパッケージ(Lambdaのコードと依存ライブラリ)を読み込みます。
- 関数内の初期化コード(データベース接続、ライブラリのインポートなど)が実行されます。
- ハンドラーの呼び出し:
- 環境の準備が完了すると、AWSが入力イベントを渡してLambda関数のハンドラーを呼び出します。
コールドスタートのレイテンシ
コールドスタートのレイテンシは、ランタイム、デプロイパッケージのサイズ、関数がVPC内で動くかどうかによって変わります。
- Node.js、Python:VPC外の関数で約200〜500ms
- Java、.NET:ランタイムの初期化が重いため約500ms〜2秒
- VPC内の関数:ENIの初期化のため、さらに約500ms〜1秒
コールドスタートとウォームスタートの違い
コールドスタートとは対照的に、ウォームスタートでは初期化済みの実行環境が再利用されます。AWSは関数の呼び出し後しばらくの間、環境を「ウォーム」な状態に保つため、後続のリクエストは初期化の手順を省略できます。
主な違い:
- コールドスタート:新しいコンテナを準備 → レイテンシが大きい
- ウォームスタート:コンテナを再利用 → レイテンシは最小限(約100ms未満)
コールドスタートを減らす方法
コールドスタートは、レイテンシに敏感なアプリケーションのパフォーマンスに大きな影響を与えます。ここでは、コールドスタートを減らすための具体的な方法を、良い例と悪い例を交えて紹介します。
1. デプロイパッケージを小さくする
良い例:
- 必要な依存関係だけを含め、不要なファイルを削除して、デプロイパッケージのサイズを最小限に抑える
- Webpack、esbuild、Parcelなどのバンドラーを使ってパッケージサイズを最適化する
- 例:
1const DynamoDB = require('aws-sdk/clients/dynamodb'); // DynamoDB だけを読み込み、SDK 全体は読み込まない
悪い例:
- モジュール単位のインポートを考慮せず、AWS SDK全体や大きなライブラリをまとめてバンドルする
- 例:
1const AWS = require('aws-sdk'); // SDK 全体を読み込むため、パッケージサイズが大きくなる
なぜ重要か:デプロイパッケージが小さいほど初期化時の読み込みが速くなり、コールドスタートのレイテンシを減らせます。
本記事のサンプルコードは、元記事の執筆時点で使われていた AWS SDK for JavaScript v2(aws-sdk)で書かれています。Node.js 18 以降の Lambda ランタイムには v3 が組み込まれているため、新しく開発する場合は @aws-sdk/client-dynamodb などの v3 のモジュールを個別にインポートしてください。必要なモジュールだけを読み込むという考え方は v3 でも同じです。
2. 重い初期化処理をハンドラーの外に移す
良い例:
- データベースやSDKクライアントの初期化など、リソースを多く使う処理はハンドラー関数の外に置き、コンテナのライフサイクルにつき1回(コールドスタート時)だけ実行されるようにする
- 例:
1const DynamoDB = new AWS.DynamoDB.DocumentClient();23exports.handler = async (event) => {4 const data = await DynamoDB.get({ Key: { id: '123' } }).promise();5 return data;6};
悪い例:
- 呼び出しのたびにハンドラー内でリソースを初期化し直す
- 例:
1exports.handler = async (event) => {2 const DynamoDB = new AWS.DynamoDB.DocumentClient(); // 呼び出しごとに初期化される3 const data = await DynamoDB.get({ Key: { id: '123' } }).promise();4 return data;5};
なぜ重要か:呼び出しのたびにリソースを初期化し直すと、レイテンシが増え、不要なコンピューティングリソースを消費します。
3. プロビジョンドコンカレンシーを有効にする(注1)
良い例:
- プロビジョンドコンカレンシーを使って一定数の実行環境を事前に初期化し、常にリクエストを処理できる状態にしておく
- 例(AWS CLI):
1aws lambda put-provisioned-concurrency-config \2 --function-name myFunction \3 --provisioned-concurrent-executions 5
- AWSマネジメントコンソールからも設定できます。
なぜ重要か:プロビジョンドコンカレンシーを使うと、初期化済みの実行環境が常に確保されるため、レイテンシに敏感なアプリケーションのコールドスタートをなくせます。
4. 依存関係を減らす
良い例:
- 使っているライブラリを見直し、重いフレームワークを軽量な代替ライブラリやネイティブAPIに置き換える
- 例:
1console.log(new Date().toISOString()); // ネイティブの JavaScript API
悪い例:
- 代替手段を検討せず、簡単な処理に重いライブラリを使う
- 例:
1const moment = require('moment');2console.log(moment().format());
なぜ重要か:依存関係が大きいとデプロイパッケージのサイズが増え、コールドスタート時の初期化が遅くなります。
5. 不要なVPC設定を避ける
良い例:
- 必要がない限り、Lambda関数はVPCの外に配置する。RDSなどのプライベートなリソースにアクセスするためにVPCが必要な場合は、VPCエンドポイントを使ってネットワークを最適化する
- 例:LambdaをVPCに入れずに、DynamoDBやS3を直接利用する
悪い例:
- VPCアクセスが不要なDynamoDBやS3などのサービスを使うだけなのに、Lambda関数をVPC内にデプロイする
- なぜ良くないか:LambdaをVPC内に配置すると、ENIの準備のためにコールドスタート時のレイテンシが増えます。
なぜ重要か:VPC外の関数はENIの準備を省略できるため、初期化が速くなります。
6. 軽量なランタイムを選ぶ
良い例:
- Javaや .NETなどの重いランタイムよりも初期化が速い、Node.jsやPythonなどの軽量なランタイムを使う
- 良い理由:軽量なランタイムは初期化に必要なリソースが少なく、コールドスタートのレイテンシが小さくなります。
なぜ重要か:重いランタイムは初期化処理が複雑なため、コールドスタートのレイテンシが大きくなります。
コールドスタート対策のベストプラクティスまとめ
- デプロイパッケージ:良い例=必要な依存関係だけを含む小さなパッケージにする/悪い例=使わないライブラリまでバンドルし、パッケージを肥大化させる
- 初期化:良い例=データベース接続などの重い初期化はハンドラーの外で行う/悪い例=リクエストのたびにハンドラー内でリソースを初期化する
- プロビジョンドコンカレンシー:良い例=レイテンシに敏感なアプリケーションで有効にする/悪い例=トラフィックの多い関数でも検討しない
- 依存関係:良い例=簡単な処理には軽量ライブラリやネイティブAPIを使う/悪い例=軽量な代替を検討せずmoment.jsのような重いライブラリを使う
- VPC設定:良い例=不要なVPC設定を避け、必要な場合はVPCエンドポイントを使う/悪い例=パブリックなAWSサービスにアクセスするだけでも、すべてのLambda関数をVPC内に置く
- ランタイムの選択:良い例=初期化の速いNode.jsやPythonを選ぶ/悪い例=シンプルで軽い処理にJavaや .NETなどの重いランタイムを使う
エラーハンドリングとログ出力
エラーハンドリングとログ出力は、Lambda関数を信頼性が高くデバッグしやすいものにするために欠かせません。効果的なエラーハンドリングはアーキテクチャ全体への障害の連鎖を防ぎ、適切なログ出力は問題の監視とトラブルシューティングを効率化します。
構造化されたエラーレスポンス
Lambda関数のエラーは、不正な入力、AWSサービスの障害、未処理の例外など、さまざまな理由で発生します。エラーハンドリングを適切に構造化しておけば、こうした問題を確実に捕捉・記録し、ユーザーや後続のサービスに正しく伝えられます。
1. 一貫したエラー構造を定義する
良い例:
- 標準的なエラーフォーマットを使い、すべてのエラーを予測可能で機械的に読み取れる形にする
- 例:
1{2 "errorType": "ValidationError",3 "message": "Invalid input: 'email' is missing",4 "requestId": "12345-abcd"5}
悪い例:
- デバッグが難しくなるような、曖昧で構造化されていないエラーを返す
1{2 "message": "Something went wrong",3 "error": true4}
なぜ重要か:構造化されたエラーは、一貫した機械可読の情報を提供するため、デバッグが容易になります。また、何が起きたのか、どう対処すべきかをクライアントや後続システムに正しく伝えられます。
2. カスタムエラークラスを使う
良い例:
- Node.jsでは、わかりやすさのためにカスタムエラークラスを定義する
1class ValidationError extends Error {2 constructor(message) {3 super(message);4 this.name = "ValidationError";5 this.statusCode = 400; // カスタムプロパティ6 }7}89// カスタムエラーをスローする10if (!event.body.email) {11 throw new ValidationError("Invalid input: 'email' is missing");12}
悪い例:
- あらゆる場面で汎用的なエラーを使い、問題の特定や分類を難しくする
- 例:
1throw new Error("Error occurred");
なぜ重要か:カスタムエラークラスを使うとエラーハンドリングがより正確になり、アプリケーションエラー(入力検証の問題など)とシステムエラー(データベース障害など)を切り分けやすくなります。
3. ログにコンテキスト情報を含める
良い例:
- エラーをログに記録する際は、requestId、timestamp、入力データ(機密情報を除く)などの関連情報を含める
- 例:
1console.error({2 errorType: "ValidationError",3 message: "The 'email' field is missing.",4 requestId: context.awsRequestId,5 input: event.body,6 timestamp: new Date().toISOString(),7});
悪い例:
- コンテキストのないエラーログを出力し、デバッグを難しくする
- 例:
1console.error("Error occurred");
なぜ重要か:ログにコンテキスト情報があれば、何がエラーの引き金になったのか、どこで発生したのかを特定しやすくなり、デバッグの効率が上がります。
AWS SDKやその他のサービスにおけるリトライロジック
外部サービスとやり取りする際には、失敗した処理のリトライが重要です。スロットリング、タイムアウト、一時的なネットワーク障害などの一時的な失敗は、ワークフローを妨げる原因になります。AWS SDK、サードパーティのAPI、社内サービスのいずれを使う場合でも、リトライロジックを適切に適用すれば、無駄なオーバーヘッドを避けながらシステムの信頼性を確保できます。
1. 指数バックオフとジッターを使う
良い例:
- ジッター付きの指数バックオフでリトライのタイミングを分散させる。特に高負荷時やレート制限がかかる場面で、対象サービスに過剰な負荷をかけずに済みます。
- 例(一般的な実装):
1async function retryWithBackoff(fn, retries = 3, delay = 100) {2 for (let attempt = 1; attempt <= retries; attempt++) {3 try {4 return await fn();5 } catch (error) {6 if (attempt === retries) throw error; // 最後の試行後は再スロー7 const backoff = delay * 2 ** (attempt - 1) + Math.random() * delay; // ジッターを加える8 console.log(`Retrying in ${backoff.toFixed()}ms...`);9 await new Promise((res) => setTimeout(res, backoff));10 }11 }12}1314// 使用例15const result = await retryWithBackoff(() => callThirdPartyAPI());
悪い例:
- 遅延やジッターなしでリトライすると、障害が連鎖し、問題を拡大させるおそれがあります。
1for (let i = 0; i < retries; i++) {2 try {3 return await callThirdPartyAPI();4 } catch (error) {5 console.log("Retrying immediately...");6 }7}
なぜ重要か:指数バックオフは障害が起きているサービスへの負荷を減らし、ジッターはリトライのタイミングをランダムにすることで、複数のクライアントが同時にリトライする「リトライストーム」を防ぎます。
2. 組み込みのリトライ機構を活用する
良い例:
- ライブラリ、SDK、APIに組み込まれたリトライロジックがある場合は、それを使う。通常、対象サービスに合わせて最適化されています。
- 例(AWS SDK):
1const DynamoDB = new AWS.DynamoDB.DocumentClient({2 maxRetries: 3, // リトライ回数3 retryDelayOptions: { base: 200 }, // 基本の遅延時間(ms)4});
- 例(サードパーティAPI向けのAxios):
- axios-retryなどのライブラリを使って、HTTPリクエストにリトライロジックを組み込みます。
1const axios = require('axios');2const axiosRetry = require('axios-retry');34axiosRetry(axios, {5 retries: 3, // 3 回までリトライ6 retryDelay: (retryCount) => retryCount * 200, // リトライごとに遅延を延ばす7 retryCondition: (error) => error.response.status >= 500, // サーバーエラーのときだけリトライ8});910const response = await axios.get("https://example.com/api");
悪い例:
- 組み込みの仕組みがあるのに独自のリトライロジックを書くと、最適でない実装になるリスクがあります。
なぜ重要か:組み込みのリトライ機構は対象のサービスやライブラリに合わせて最適化されていることが多く、バグや設定ミスの可能性を減らせます。
3. サービスごとにリトライ回数の上限を設定する
良い例:
- サービスの特性や重要度に応じてリトライの上限を設定する
- 例(AWS S3へのアップロード):
1const s3 = new AWS.S3({2 maxRetries: 5, // 重要な処理ではリトライ回数を多めに3 retryDelayOptions: { base: 300 }, // 基本の遅延時間をやや長めに4});
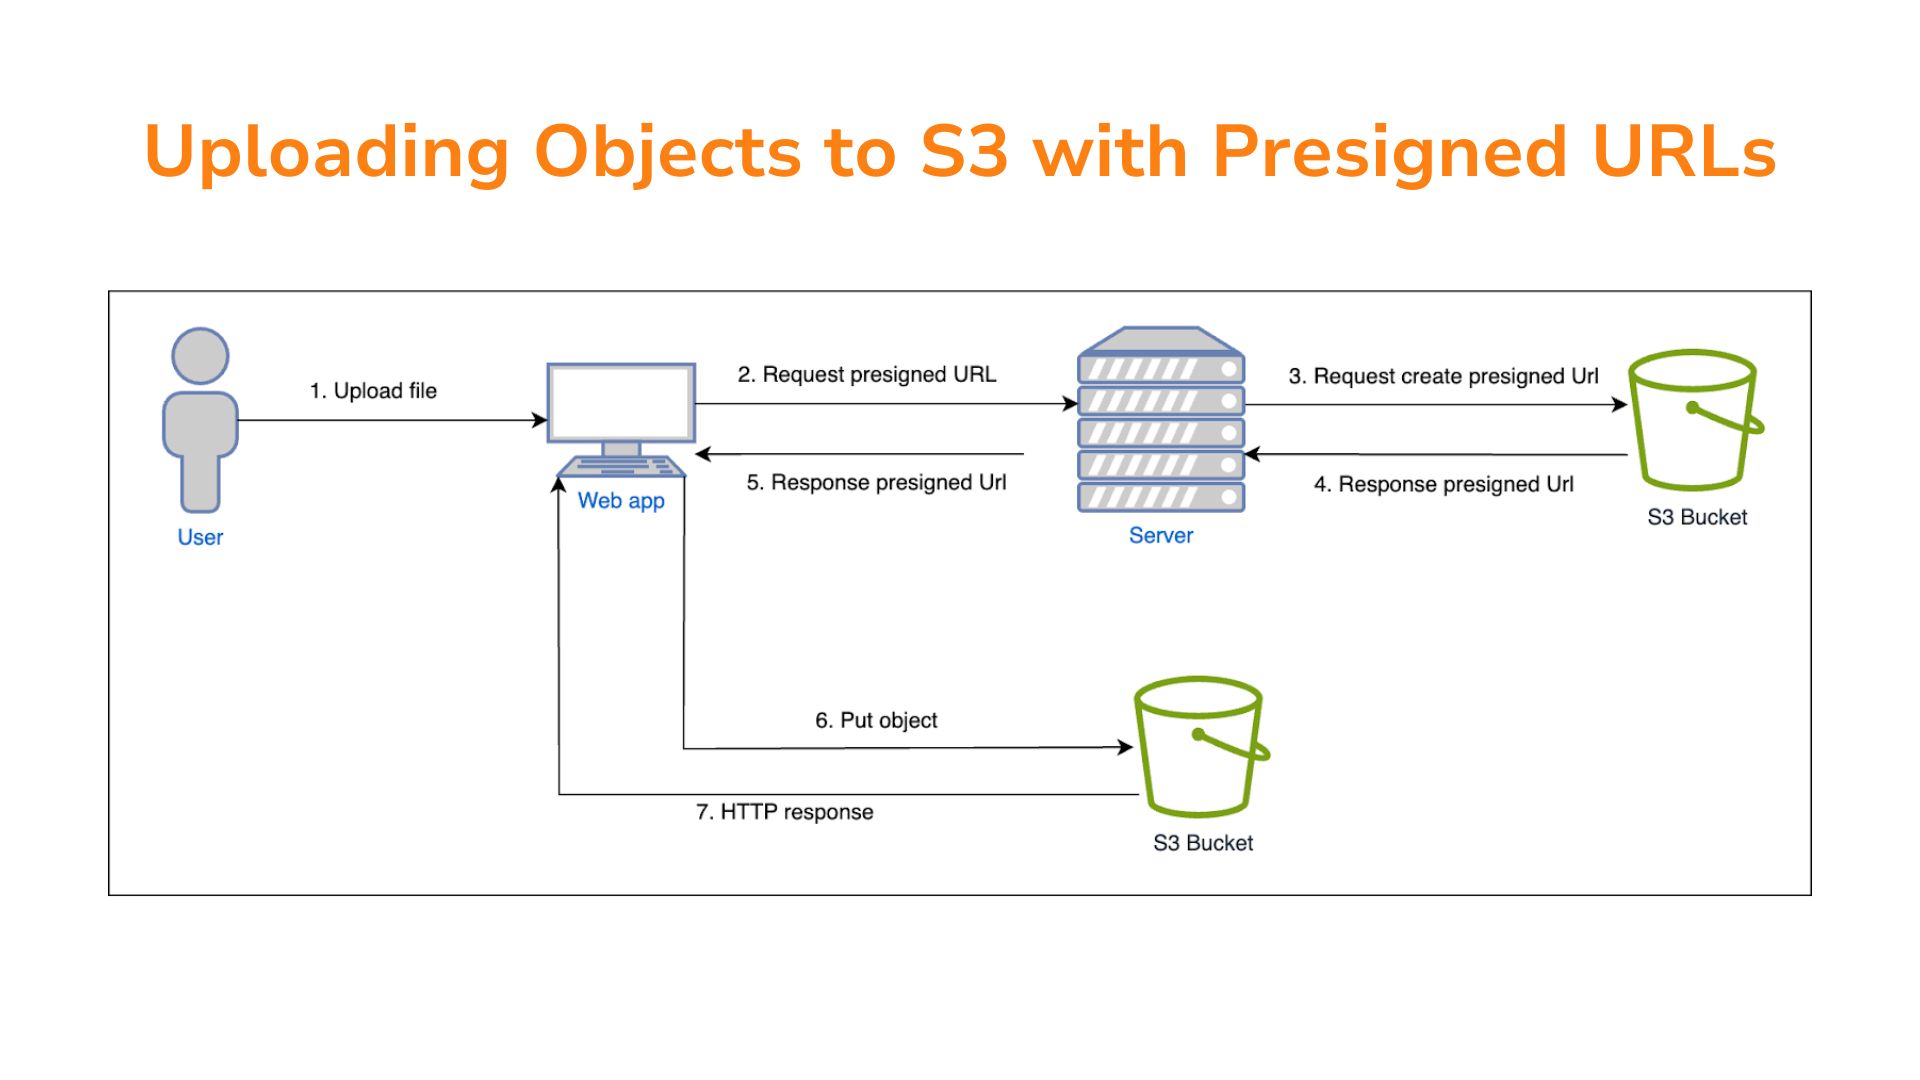
あわせて読みたい:署名付きURL(Presigned URL)でAmazon S3にオブジェクトを直接アップロードする方法
- 例(データベースクエリ):
1async function queryDatabaseWithRetry(queryFn) {2 await retryWithBackoff(queryFn, 5, 100); // 独自のバックオフロジックでリトライ3}
悪い例:
- リトライを無制限に許可すると、リソースの枯渇やコストの増加につながります。
1while (true) {2 try {3 return await callService();4 } catch (error) {5 console.log("Retrying...");6 }7}
なぜ重要か:過剰なリトライは、想定外のコスト増加やシステム全体への障害の連鎖を招きます。必ず妥当なリトライ上限を設定しましょう。
4. 一時的な障害と恒久的な障害を区別する
良い例:
- 一時的な障害(タイムアウト、スロットリング、5xxエラーなど)だけをリトライし、恒久的な障害(不正な入力、4xxエラーなど)はすぐに処理する
- 例:
1const isTransientError = (error) =>2 error.code === "ThrottlingException" || error.code === "TimeoutError";34async function callServiceWithRetry() {5 await retryWithBackoff(() => {6 if (!isTransientError(error)) throw error; // 恒久的なエラーはリトライしない7 return callService();8 });9}
悪い例:
- ValidationExceptionや404 Not Foundなどの恒久的な障害も含め、すべてのエラーを無差別にリトライする
なぜ重要か:恒久的な障害はリトライしても成功する見込みが低く、リソースを無駄にするだけです。
5. リトライの試行をログに記録する
良い例:
- リトライ回数や遅延時間など、関連するコンテキストとともに各リトライをログに記録する
1async function retryWithBackoff(fn, retries = 3, delay = 100) {2 for (let attempt = 1; attempt <= retries; attempt++) {3 try {4 return await fn();5 } catch (error) {6 if (attempt === retries) throw error;7 console.log(`Attempt ${attempt} failed. Retrying in ${delay}ms...`);8 await new Promise((res) => setTimeout(res, delay));9 }10 }11}
悪い例:
- リトライをログに残さないと、デバッグやリトライ時の挙動の把握が難しくなります。
なぜ重要か:ログはシステムの挙動を知るための貴重な手がかりとなり、リトライに関する問題の診断に役立ちます。
リトライロジックのベストプラクティスまとめ
- リトライロジック:良い例=ジッター付きの指数バックオフでリトライを分散させる/悪い例=遅延なしで即座にリトライし、リトライストームを引き起こす
- 組み込みの仕組み:良い例=AWS SDKのリトライオプションやaxios-retryなどのライブラリを活用する/悪い例=最適化された組み込みの仕組みがあるのに、独自のリトライロジックを書く
- リトライ上限:良い例=妥当なリトライ上限(3〜5回など)を設定する/悪い例=リトライを無制限に許可し、リソースの枯渇やコスト増加を招く
- 一時的な障害と恒久的な障害:良い例=一時的なエラー(タイムアウト、スロットリングなど)だけをリトライし、恒久的なエラーはすぐに失敗させる/悪い例=入力検証エラーや404など恒久的な障害も含めてすべてリトライする
- ログ出力:良い例=試行回数、遅延時間、エラーなどのコンテキストとともにリトライを記録する/悪い例=リトライを記録せず、挙動の追跡や問題の診断を難しくする
ログ出力のベストプラクティス
ログは、Lambda関数のデバッグと監視に欠かせません。ただし、構造化されていないログや過剰なログは、必要な情報を見つけにくくします。
1. 機密データをマスクまたは除外する
良い例:
- 次のような機密情報をログに出力しない
- ユーザーの認証情報
- APIキー、トークン、シークレット
- 個人を特定できる情報(PII)
- 機密データの管理にはAWS Secrets Managerなどのツールを使う
- 例:ログ出力の前に機密フィールドをマスクする
1const sanitizedInput = {2 ...event,3 password: "***",4};56console.log(JSON.stringify({7 level: "info",8 message: "User login attempt logged.",9 input: sanitizedInput,10}));
悪い例:
- 機密データを直接ログに出力すると、セキュリティ侵害やコンプライアンス違反(GDPR、HIPAAなど)につながるおそれがあります。
- 例:
1console.log(`User logged in with password: ${event.password}`);
なぜ重要か:機密データをログに出力すると、システムが攻撃者にさらされ、コンプライアンスに違反し、ユーザーの信頼を損なうおそれがあります。
2. ログの保持期間を設定する
良い例:
- CloudWatchのロググループに保持期間を設定し、ログの保存コストが膨らむのを防ぐ
- AWSでは保持期間を設定できます(7日、14日、30日など)。
悪い例:
- デフォルトの「失効しない(Never Expire)」設定のまま、ログを無期限に保存し続ける
なぜ重要か:管理されていないログはコストを増やし、必要なデータを探しにくくします。必要な期間だけログを保持すれば、コストを抑えつつログを管理しやすく保てます。
3. 過剰なログ出力を避ける
良い例:
- システムの挙動の監視、トラブルシューティング、分析に必要なものだけをログに出力する
- info、debug、errorのレベルを使い分けて、ログに適切な優先度をつける
1console.info("Function started processing...");2console.error("Failed to fetch data from DynamoDB: ", error.message);
悪い例:
- 入力ペイロードや実行ステップなど、あらゆる詳細をログに出力し、ログの量を不必要に増やす
- 例:
1console.log(`Received event: ${JSON.stringify(event)}`); // ペイロード全体を不必要にログ出力しない
なぜ重要か:過剰なログはストレージを圧迫し、コストを増やし、必要なログを見つけにくくします。
4. ログレベル(info、debug、error)を使い分ける
良い例:
- 重要な情報とそうでない情報を区別するために、ログレベルを使い分ける
- info:関数の開始や正常終了など、一般的な実行ログ
- debug:開発中やトラブルシューティング時の詳細なログ
- error:すぐに対応が必要な障害
悪い例:
- 優先度をつけず、単一のログレベル(あらゆる場所でconsole.log()を使うなど)だけで出力する
なぜ重要か:ログレベルを使い分ければ、重要度でログを絞り込み、本番環境で重大な問題に集中しやすくなります。
まとめ
今回の「Mastering AWS Lambda with Bao」では、パフォーマンスの最適化、エラーハンドリング、ログ出力を中心に、信頼性の高いAWS Lambda関数を構築するための重要なベストプラクティスを紹介しました。
- パフォーマンスの最適化:コールドスタートを減らし、小さなデプロイパッケージと軽量なランタイムを使い、VPC設定を最適化することで、レイテンシを大幅に削減できます。初期化処理をハンドラーの外に移したり、プロビジョンドコンカレンシーを活用したりすれば、レイテンシに敏感なアプリケーションもスムーズに実行できます。
- エラーハンドリング:構造化されたエラーレスポンスとカスタムエラークラスを導入すれば、トラブルシューティングが容易になり、一時的な問題と恒久的な問題を区別しやすくなります。エラーを一貫して扱うことで、システムの回復力が高まります。
- リトライロジック:ジッター付きの指数バックオフ、組み込みのリトライ機構、妥当なリトライ上限を組み合わせれば、依存するサービスに過剰な負荷をかけることなく、Lambda関数が障害にうまく対処できるようになります。
- ログ出力:構造化されたフォーマット、コンテキスト情報、ログレベル、適切な保持期間による効果的なログ出力は、可視性、デバッグ効率、コスト管理を向上させます。ログに機密データを含めないことで、セキュリティとコンプライアンスも確保できます。
これらのベストプラクティスに従えば、Lambda関数のパフォーマンスを最適化して運用コストを抑え、スケーラブルで信頼性が高く安全なサーバーレスアプリケーションをAWS Lambdaで構築できます。
次回は、「デッドレターキュー(DLQ)による障害への対処」を取り上げ、DLQが失敗したイベントを捕捉するセーフティネットとして機能し、ワークフローでのデータ損失を防ぐ仕組みを解説します。
注記:
注1:プロビジョンドコンカレンシーは万能な解決策ではありません。コールドスタートをなくせる一方で、事前に初期化された環境は利用の有無にかかわらず課金されるため、追加のコストが発生します。
- 使うべきケース:
- APIやリアルタイムアプリケーションなど、わずかな遅延も許されないレイテンシ重視のワークロード
- 使うべきでないケース:
- バッチジョブや呼び出し頻度の低いトリガーなど、呼び出し頻度が低い、または予測できない関数。このような場合は、オンデマンドのコンカレンシーのほうが費用対効果が高いことがあります。
出典:Best Practices for Building Reliable AWS Lambda Functions(SupremeTech、著者:Bao Dang)。日本語に翻訳して掲載しています。