この記事のポイント
- アプリケーションのオートスケーリングは、フラッシュセールやキャンペーン、買い物のピーク時間帯でも小売システムを高速に保ちます。
- トラフィックが増えるとコンピューティングリソースを自動で増やし、需要が落ち着くと自動で減らします。
- 主な指標は、CPU使用率、メモリ、リクエスト数、ネットワークトラフィック、アプリケーション独自のカスタムメトリクスです。
- トラフィックの多い小売システムには、インスタンス、コンテナ、Podを追加する水平スケーリングが通常は適しています。
- ロードバランサー、ヘルスチェック、クールダウン期間、スケジュールに基づくスケーリング、予測スケーリングを組み合わせることで、オートスケーリングはより安定します。
- SupremeTechの事例では、AWS、Amazon ECS、AWS WAF、パフォーマンステストを活用し、急激なトラフィックの増加に安定して対応しました。
最近の小売システムは、顧客のアクセスが急増する場面に対応しなければなりません。たとえば季節のセールやフラッシュセール、ピーク時間帯には、多くのユーザーが同時に商品を閲覧し、カートで決済し、ポイント特典を利用します。適切なインフラがなければ、こうした需要の急増によってパフォーマンスが低下し、エラーが発生し、アプリケーションが停止することさえあり、売上とブランドの評判に直接影響します。
アプリケーションのオートスケーリングは、リアルタイムの需要に応じてコンピューティングリソースを自動で調整し、負荷が変動しても小売アプリケーションの応答性を保つクラウドネイティブな仕組みです。簡単に言えば、トラフィックが増えたときには常に十分なリソースを確保し、需要が落ち着いたらリソースを縮小することで、パフォーマンスとコストの両方を最適化します。
AWS、Google Cloud、Microsoft Azureなどのクラウド環境では、オートスケーリングは通常、水平スケーリングの戦略の一部として実装されます。ワークロードの大きさに応じて、アプリケーションやサービスのインスタンスが自動で追加・削除される仕組みです。たとえばフラッシュセールでユーザーのリクエストが急増すると、オートスケーリングが新しいインスタンスを追加して負荷を分散し、速度の低下を防いでスムーズな顧客体験を維持します。ピークが過ぎると、追加したリソースを削除してコストを抑えます。
オートスケーリングが小売の可用性とユーザー体験を高める仕組み
需要が集中する時間帯のアプリケーションのパフォーマンスは、顧客体験に直結します。オートスケーリングを有効にすると、インフラがトラフィックのパターンに自動で反応し、応答の遅れを防ぐためにサーバーインスタンスを追加し、トラフィックが少ないときには減らしてコストを節約します。
小売業にとってこれは、大型セールや販促イベントの最中でもオンラインストアが高速かつ安定して動き、決済処理の応答性が保たれ、在庫照会やポイント更新などの重要なサービスが途切れることなく続くことを意味します。オートスケーリングの自動化により、手作業での介入が最小限に抑えられ、予測できない負荷のもとでも業務をスムーズに維持できます。
アプリケーションのオートスケーリングとは?その仕組み
アプリケーションのオートスケーリングは、リアルタイムの需要に応じてアプリケーションのコンピューティングリソースを自動で調整する、クラウド環境の中核的な機能です。サーバーを手作業で追加・削除する代わりに、定義されたパフォーマンス指標を監視してスケーリングを判断し、アプリケーションの応答性と効率を保ちます。ピーク時間帯にトラフィックが予測できない形で急増する小売システムでは、インフラを過剰に用意せずにパフォーマンスを維持するために、この自動化が欠かせません。
オートスケーリングの基本的な仕組み
アプリケーションのオートスケーリングの中核は、継続的な監視、指標の評価、自動的なスケーリングアクションです。AWS、Google Cloud、Azureなどのクラウドプラットフォームは、パフォーマンスのシグナル(CPU使用率、リクエスト数、メモリ使用量、その他のカスタムメトリクスなど)を追跡し、しきい値に達するとアクションを実行します。
- 監視:システムがアプリケーションのインスタンスやコンテナから継続的に指標を収集します。
- トリガー:指標があらかじめ定めた上限を超えたときに発動します。たとえばCPU使用率が70%を超えた状態が続くと、オートスケーリングポリシーがスケールアウトを開始します。
- スケールアウト:新しいアプリケーションのインスタンスやリソースを用意して負荷を分担し、受信したリクエストをより多くのサーバーに分散します。
- スケールイン:需要が減って指標が「スケールイン」のしきい値を下回ると、余分なリソースを削除してコストを抑えます。
- クールダウン期間:多くのオートスケーリングの実装には、スケールアウトとスケールインが短時間に繰り返されて不安定になるのを防ぐための、クールダウンの間隔が設けられています。
水平スケーリングと垂直スケーリング
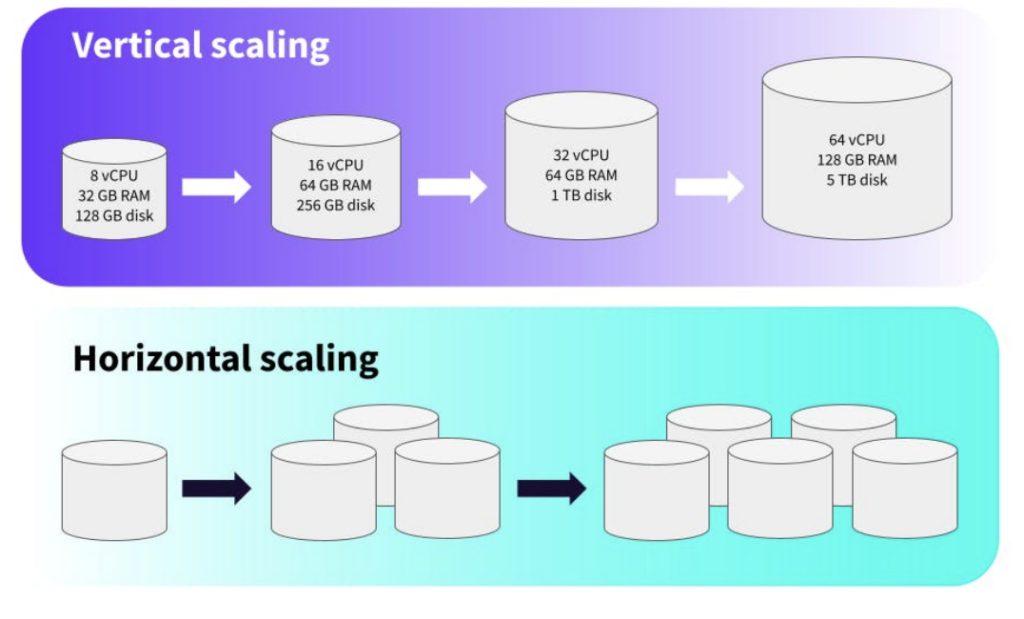
オートスケーリングには、主に2つの方式があります。
- 水平オートスケーリング(スケールアウト/スケールイン):独立したインスタンス(サーバー、仮想マシン、コンテナ)を追加・削除します。柔軟性と耐障害性に優れているため、最近のクラウドシステムで最も一般的な方式です。トラフィックが増えると新しいインスタンスが起動し、減ると削除されるため、リソースを効率よく使えます。
- 垂直オートスケーリング(スケールアップ/スケールダウン):新しいインスタンスを作らずに、既存のインスタンスのリソース(CPUやメモリなど)を増減します。一部の環境では可能ですが、再起動が必要になることが多く、拡張にも限界があるため、トラフィックの多い小売アプリケーションではあまり使われません。
スケーリングポリシーと指標
アプリケーションのオートスケーリングは、開発チームや運用チームが定義するポリシーに基づいて動作します。ポリシーでは、次の項目を指定します。
- 監視する指標:CPU使用率、メモリ消費量、リクエスト数、カスタムシグナル(キューの長さなど)が代表的です。
- しきい値:スケールアウトやスケールインを発動する指標の水準です。
- リソースの最小数・最大数:維持するインスタンスの最小数と、スケーリングで許容する最大数です。
- クールダウンの設定:スケーリングの後、システムが安定するまで次のスケーリングを止めておく期間です。
ロードバランサーとヘルスチェックとの連携
オートスケーリングは単独で動くわけではありません。多くのクラウド環境では、次の仕組みと密接に連携しています。
- ロードバランサー:受信したトラフィックを、利用可能なインスタンスに均等に振り分けます。新しいインスタンスが追加されると、ロードバランサーは自動的にそのインスタンスにもリクエストを送り始めます。
- ヘルスチェック:正常なインスタンスだけがトラフィックを受け取るようにします。インスタンスに障害が起きた場合、オートスケーリンググループが人手を介さずに置き換えます。
これらの仕組みが連携することで、小売のピーク時間帯やフラッシュセールのようにユーザーが急に押し寄せる場面でも、パフォーマンスと稼働率を維持できます。
クラウドアーキテクチャに関する関連記事:
- The Importance of Performance Testing and SupremeTech’s Expertise(英語)
- AWS Lambdaのトリガーとイベント:S3・DynamoDB StreamsでLambda関数を動かす方法
アプリケーションのオートスケーリングを支える基本概念
アプリケーションのオートスケーリングを理解するうえでの出発点は、クラウドシステムは需要の変化に応じて自らを自動で調整すべきだ、という考え方です。トラフィックが予測できない形で急増する小売のピーク時間帯には、特にそれが重要になります。手作業での介入に頼るのではなく、変動するワークロードの中でもアプリケーションの応答性、効率、費用対効果を保つのがオートスケーリングです。
リソースの柔軟な調整
アプリケーションのオートスケーリングの本質は、リアルタイムのパフォーマンス指標に基づいて、クラウドインフラがコンピューティングリソースを自動で追加・削除できるようにすることです。その目的は、リソースを過剰に用意したり、使い切れずに余らせたりすることなく、パフォーマンスと可用性を維持することにあります。たとえば販促期間中に多くの顧客が商品を閲覧・検索・購入して需要が高まると、オートスケーリングはワークロードの増加を検知し、インスタンスを追加してスケールアウトします。需要が落ち着くとスケールインして余分なリソースを削除し、コストの削減に貢献します。
水平スケーリングと垂直スケーリング
オートスケーリングには、主に2つのスケーリング戦略があります(英語)。
- 水平スケーリング(スケールアウト/スケールイン):需要の変化に合わせて、アプリケーションのインスタンス(サーバーやコンテナ)単位で追加・削除します。ワークロードを処理するユニットの数を増やして処理能力を高めるため、負荷分散が重要なステートレスで分散型の小売システムに特に適しています。
- 垂直スケーリング(スケールアップ/スケールダウン):個々のインスタンスのリソース容量(CPUやメモリなど)を変更します。限られた場面では有効ですが、一般にインスタンスの再起動が必要で、物理的な上限にも達しやすいため、トラフィックの多い小売サイトにはあまり向いていません。
トラフィックのパターンが予測できない場合や急速に伸びている場合には特に、耐障害性と応答性を高められる水平オートスケーリングが、最近の小売アプリケーションの多くで採用されています。
監視と指標
オートスケーリングで重要なのは、システムが監視する指標です。代表的なシグナルには次のようなものがあります。
- CPU使用率
- メモリ使用量
- ネットワークトラフィック
- 1秒あたりのリクエスト数
- アプリケーション固有のカスタムメトリクス
オートスケーラーは、これらのパフォーマンス指標を継続的に監視しています。ポリシーで定めたスケーリングのしきい値をいずれかの指標が超えると、適切なスケーリングアクションを実行します。たとえばセール期間中にCPU使用率が指定の上限を超え続けると、システムはパフォーマンスを維持するために自動で新しいインスタンスを起動します。
ロードバランシングとヘルスチェック
ロードバランサーとヘルスチェックは、オートスケーリングを支える欠かせない要素です。新しいインスタンスが追加されると、ロードバランサーは受信したトラフィックを正常なすべてのインスタンスに均等に振り分け、特定のリソースに負荷が集中しないようにして、安定したパフォーマンスを保ちます。ヘルスチェックは各インスタンスの状態を監視し、正常に動作するユニットだけがトラフィックを受け取るようにします。ヘルスチェックに失敗したインスタンスは、オートスケーリングのポリシーによって終了され、新しいインスタンスに置き換えられるため、高い可用性を維持できます。
スケジュールに基づくスケーリングと予測スケーリング
指標がしきい値を超えたときに反応する事後型のスケーリングに加えて、スケジュールに基づくスケーリング(時間やイベントに基づく事前定義のルール)や予測スケーリング(過去のパターンと予測の活用)に対応したシステムもあります。スケジュールに基づくスケーリングは、毎日の昼食時のトラフィック増加や季節のセールなど、あらかじめわかっているピークに備えるものです。予測オートスケーリングは、過去のワークロードのパターンと機械学習を使って需要を予測し、前もって容量を調整することで、突然の需要の急増時にリソースが不足するリスクを減らします。
小売のピーク時間帯にオートスケーリングはどう動くのか
アプリケーションのオートスケーリングが特に威力を発揮するのは、フラッシュセール、ホリデーキャンペーン、大型の販促イベントなど、ピーク時間帯にトラフィックが急増する小売の環境です。こうした期間中、システムはパフォーマンスを維持し、増えたリクエストを処理し、スムーズな顧客体験を確保するために、動的に調整を行う必要があります。ここでは、需要が急増してから落ち着くまでに、オートスケーリングが実際にどう動くのかを順を追って説明します。
需要の急増をリアルタイムで検知する
ピーク時間帯、オートスケーラーはアプリケーションのインスタンスから得られるCPU使用率、リクエスト数、その他のカスタムシグナルなどの主要なパフォーマンス指標を常に監視しています。これらの指標が事前に定めたしきい値を超えると、オートスケーラーは需要が増えたと判断し、スケーリングを開始します。監視は数秒から数分ごとに行われるため、トラフィックのパターンの変化にすばやく反応できます。
スケールアウト:リソースを追加する
トリガーの条件に達すると、オートスケーラーはスケールアウトを実行し、コンピューティングリソースを追加します。アーキテクチャによって、新しいサーバーインスタンス、コンテナ、Podなどが追加されます。たとえば次のとおりです。
- Kubernetes環境では、Podが自動で追加されます。
- クラウドの仮想マシン構成では、新しいVMが起動し、オートスケーリンググループの一部として設定されます。
追加された各ユニットによって、アプリケーションが処理できる同時ユーザー数や取引数が増えます。システムによっては、新しいPodやインスタンスがアプリケーションの完全なレプリカとなるため、トラフィックの増加に合わせて冗長性と耐障害性も確保できます。
ロードバランシングとヘルスチェック
オートスケーリングは、受信したリクエストを利用可能なすべてのインスタンスに均等に振り分けるロードバランサーと連携して動作します。新しいインスタンスが起動すると、ロードバランサーはほぼすぐにトラフィックを送り始めます。ヘルスチェックによって、正しく起動したインスタンスだけが処理に加わります。ヘルスチェックに失敗したインスタンスは対象から外され、オートスケーラーが代わりのインスタンスを作成することもあります。この連携によって、トラフィックが急激に変化する中でもパフォーマンスと可用性が保たれます。
予測スケーリングとスケジュールに基づくスケーリング
リアルタイムの状況に反応する事後型のオートスケーリングが一般的ですが、多くの小売のシナリオでは、予測スケーリングやスケジュールに基づくスケーリングも効果的です。予測オートスケーリングは、過去のパターンと予測モデルを使ってトラフィックが急増する前に容量を追加するため、突然の需要の増加による遅延を防げます。たとえば平日の昼食時にいつもトラフィックが急増するアプリケーションであれば、予測オートスケーリングがその時間帯の前から容量を増やし始めます。
スケジュールに基づくスケーリングも有効な手法で、計画された販促の開始前にインスタンスを追加し、終了後に削除するといったように、あらかじめ決めた時刻にスケーリングのルールを実行します。小売企業は、予測できるピーク期間に合わせてスケジュールを設定し、必要なときに必要な容量を確保できます。
ピーク後の安定化とスケールイン
ピーク時間帯が過ぎて需要が落ち着き始めると、オートスケーラーはスケールインの段階に入ります。リソースを減らす前に、需要の減少が一時的な落ち込みではなく継続的なものであることを確かめるため、一定の安定化期間を置くのが一般的です。これにより、パフォーマンスを不安定にしたり余計なコストを生んだりする、スケールインとスケールアウトの頻繁な繰り返しを防げます。
この段階では、システムが設定された最小容量に達するまで、追加したインスタンスが段階的に削除されます。適度な負荷のもとでもパフォーマンスを損なうことなく、コストを削減できます。
アプリケーションのオートスケーリングが小売のパフォーマンスとコストにもたらすメリット
小売システムにとって、アプリケーションのオートスケーリングは技術的なパフォーマンスのメリットとビジネス面でのコストメリットの両方をもたらす、最新のクラウドネイティブアーキテクチャに欠かせない機能です。適切に設計すれば、ピーク時の需要に対して小売アプリケーションの応答性を保ちつつ、閑散期の不要なインフラコストを避けられます。
ピーク時もパフォーマンスを維持する
オートスケーリングの最もわかりやすいメリットのひとつが、ワークロードが変動してもパフォーマンスが安定することです。コンバージョンや顧客満足度に直接影響する応答の遅れ、タイムアウトエラー、サービス停止を防げます。需要に合わせてリソースが増えるため、負荷が急増しても応答時間は安定します。
可用性と耐障害性を高める
オートスケーリングは、複数のインスタンスに処理を分散し、障害が起きたインスタンスを自動で置き換えることで、システム全体の回復力を高めます。ピーク時にサーバーが異常な状態になっても、オートスケーリングが新しいインスタンスを起動して正常なインスタンスにトラフィックを振り分け直すため、手作業での介入なしに稼働を維持できます。これは、24時間365日稼働し、世界中からのトラフィックに安定して応えなければならない小売システムにとって特に重要です。
グローバル規模での拡張を支える
複数の地域で顧客にサービスを提供する小売ブランドは、地域をまたいでリソースを拡張できるオートスケーリングの恩恵を受けられます。ロードバランシングと組み合わせることで、需要のある場所の近くにコンピューティングリソースを配置してユーザーにより効率的にサービスを提供し、レイテンシを減らして、世界中の顧客体験を向上させられます。
SupremeTechの専門性とのつながり
アプリケーションのオートスケーリングを効果的に導入するには、専門知識が欠かせません。特に、実際のトラフィックのパターンに合ったオートスケーリングポリシーの設計、構成、最適化について、外部の支援を必要とする小売企業は少なくありません。SupremeTechのクラウド・DevOpsの対応力(英語)は、こうした課題を抱える小売企業の競争力強化を支援します。
SupremeTechのクラウドインフラ&DevOpsサービスは、オートスケーリングを最大限に活かすクラウド環境の設計と構築を支援します。主な支援内容は次のとおりです。
- 小売のワークロードに合わせたアーキテクチャの計画と構成により、オートスケーリングのポリシーをトラフィックの動きに合わせて最適化します。
- 移行と最適化のサービスにより、レガシーシステムを、スケーラブルでオートスケーリングに対応したクラウド環境へ移行します。
- 継続的なパフォーマンスチューニングと監視ツールとの連携により、オートスケーリングのトリガーを応答性が高くコスト効率のよいものに保ちます。
オートスケーリングと体系的なクラウドアーキテクチャの支援を組み合わせることで、小売企業は、予測できないピーク需要のもとでも優れた顧客体験を届けるために必要な、パフォーマンス、コスト効率、信頼性を実現できます。
SupremeTechによる高トラフィック小売アプリケーションへのオートスケーリング導入事例
ある小売アプリケーションのプロジェクトで、SupremeTechは、ピーク時間帯や販促キャンペーン中のユーザーアクセスの急増に対応できるシステムを設計しました。目標は、トラフィックが急増しても、注文と決済の体験を高速かつ安定して保つことでした。
そのために、プラットフォームをAWSクラウド上に構築し、サービスをAmazon ECSで管理しました。インフラはリクエスト量が増えると自動でスケールアウトし、トラフィックが通常の水準に戻るとスケールダウンします。これにより、インフラの利用を最適化しながら、安定したパフォーマンスを維持できるようになりました。
さらに、異常なトラフィックや悪意のあるトラフィックからプラットフォームを守るためにAWS WAFを導入しました。リリース前には大規模なパフォーマンステストを実施し、ピーク時の状況をシミュレーションしています。このオートスケーリングのアーキテクチャにより、アプリケーションは大幅なトラフィックの急増にも対応しながら、スムーズで信頼性の高いユーザー体験を維持できます。
まとめ
アプリケーションのオートスケーリングは、予測できないピークトラフィックのもとでも、小売システムの応答性とコスト効率を保ちます。需要に応じてリソースを自動でスケーリングすることで、小売企業は販促、年末年始の繁忙期、フラッシュセールの間もパフォーマンスと可用性を維持できます。SupremeTechのクラウド・DevOpsサービスのような専門的な支援とともに導入すれば、オートスケーリングは回復力とスケーラビリティに優れた小売インフラの中核になります。デジタルコマースが成長し続ける中で、過剰なクラウドコストをかけずにシームレスな顧客体験を届けるには、オートスケーリングを使いこなすことが欠かせません。
小売システムのクラウドインフラやオートスケーリングの設計についてのご相談は、SupremeTechまでお気軽にお問い合わせください。
よくある質問
小売システムにおけるアプリケーションのオートスケーリングとは何ですか?
アプリケーションのオートスケーリングとは、リアルタイムの需要に応じてコンピューティングリソースを動的に調整し、トラフィックの急増時にもパフォーマンスとコストを最適化するクラウドの機能です。
オートスケーリングはピーク時のパフォーマンスをどう改善しますか?
オートスケーリングは主要な指標を監視し、需要が増えると自動でリソースを追加します。これにより速度低下やサービス停止を防ぎ、スムーズなユーザー体験を維持できます。
オートスケーリングは小売企業のクラウドコスト削減に役立ちますか?
はい。需要が減るとリソースを縮小するため、小売企業は使った分だけを支払えばよく、不要なクラウドコストを削減できます。
小売プラットフォームでオートスケーリングを発動させるトリガーは何ですか?
CPU使用率、メモリ使用率、リクエスト数、またはECのトラフィック量に連動したカスタムメトリクスなどがトリガーになります。
小規模な小売企業でもオートスケーリングを使えますか?
はい。ほとんどのクラウドプロバイダーが、小規模な小売企業でも利用しやすく手頃な価格のオートスケーリング機能を提供しています。
出典:How Application Autoscaling Works for Retail Systems During Peak Hours(SupremeTech、著者:Quy Huynh)。日本語に翻訳して掲載しています。